一美元的AI订阅:AI 巨头为何亏本也要挤进政府?
「正文约5600字」
人们从命运得到的一切,冥冥之中都记下了它的价钱。
——茨维格 《断头皇后》
摘要
美国政府近乎 「白嫖」 顶尖 AI 企业最前沿的大模型。手握顶尖技术的OpenAI等巨头,为何甘愿低价把顶尖AI送入政务系统?答案是一场心照不宣的双向捆绑、利益互换。AI企业的算力、基建、合规审批全靠政府放行,入局政务是为换取政策绿灯;同时,政务真实、复杂的治理场景,是普通商业市场无法替代的产品试验场,能快速迭代模型、适配官方标准,锁定长期政府采购红利。但深层的政治风险极具隐蔽性:AI 介入执法、福利、移民等公共事务后,会依靠风险评分生成大量隐形、不透明的治理分类。
每到工作日下午,AI有时就会突然变慢。我盯着那个转个不停的圆圈,等它把一句话吐完。模型越来越聪明,价格也越来越贵,但算力并不总在我需要的时候出现。AI的确提高了我的工作效率,我甚至已经离不开AI,我也因此更容易对这种等待感到烦躁。
我把这件事抱怨给一位在AI企业工作的朋友,顺口问她:如果以后大量政务都要靠AI,难道不会因为卡顿而「差评如潮」?她告诉我,面向政府的产品不是个人订阅的简单升级版。它们有单独的采购通道、技术支持和机构级接入。
总在屏幕前等待转圈结束的我不禁想问,政府为这些「更好的」服务付了多少钱?
2025年8月,OpenAI 与美国联邦总务署达成协议,参与的联邦行政机构可在一年内以每机构1美元使用 ChatGPT Enterprise。
2025年8月,美国联邦总务署宣布了一笔看起来很不合常理的交易。OpenAI 把 ChatGPT Enterprise 提供给联邦行政机构,每个参与机构一年只收「一美元」。几天以后,Anthropic 给行政、立法和司法三个分支开出同样的价格。Google 更低,Gemini for Government 每机构四十七美分。[1]
2025年8月,美国联邦总务署与 Google 达成 OneGov 协议,联邦机构可按每机构0.47美元的价格使用 Gemini for Government,产品包括 Gemini 模型、NotebookLM、企业搜索和 AI Agent 等工具。
我起初把AI企业的这类商业行为理解成一种促销,政府采购一旦形成规模,后续合同也可能很大。但「一美元」仍让我感到困惑。企业级AI需要安全认证、技术支持和内部接入,这些成本不会因为合同上写了一个象征性的数字就消失。
我的朋友告诉我,想要理解这件事,只需要沿着两条线往下看。一条通向数据中心:AI生产越来越依赖电力、土地、芯片许可和基础设施审批。另一条通向政府办公室:公共部门正在成为前沿模型发现新需求、修正产品能力的实验场。
沿着这两条线索,政治问题也随之出现。公共力量帮助建设的AI基础设施究竟服务谁?成本怎样分担?当AI进入福利、执法、移民和医疗,它又会怎样参与政府对人的分类,被影响的人能否知道这些判断从何而来?
钱买不到的那部分
AI公司的资本开支已经大到很难用日常经验理解,但「钱」并不能解决所有问题。
英伟达仍在出售先进芯片,但美国的出口管制已经让一部分先进芯片的交易不能仅由买卖双方决定。美国商务部工业与安全局把先进计算能力与军事、情报和武器用途联系起来,某些交易必须取得政府许可。即使企业愿意为芯片加价,也不能跳过这一管制程序。[2]电力供应的政治依赖更为直观。企业的数据中心不能自己把一根电缆接进电网,大型项目要经过并网研究,往往还牵涉输电线路和变电设施的新建。监管机构不仅要评估电网能否承受,也要判断新增成本会不会成为普通用户的电费负担。
2026年8月,德克萨斯州州长格雷格·阿博特(Greg Abbott)要求公共事业委员会和德州电力可靠性委员会审核正在推进的大型数据中心并网项目,审核完成前,相关项目不能继续向前走,因为当时潜在的大型负荷申请超过474吉瓦,远高于德州电网的历史峰值负荷。不难看出,即使企业可以买回服务器,也不能仅凭购买力决定通电时间。[3]
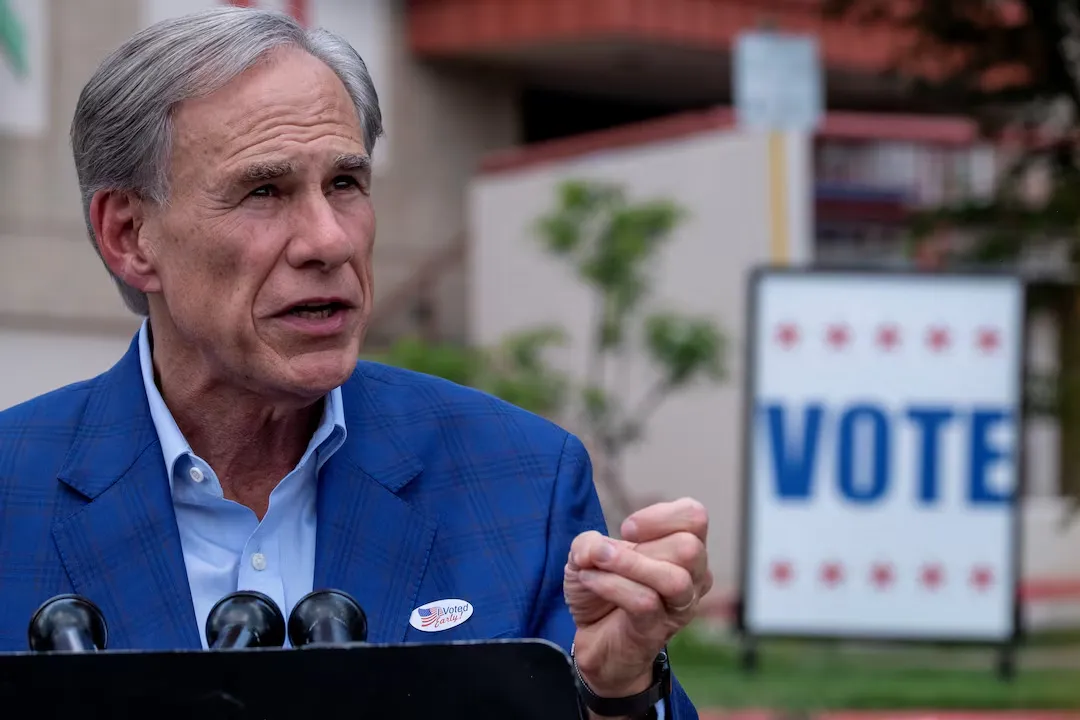
德克萨斯州州长格雷格·阿博特(Greg Abbott)。2026年8月,阿博特要求州公共事业委员会与 ERCOT 全面核验正在推进的数据中心并网项目,审核完成前相关项目不得继续推进。图为阿博特2026年5月在奥斯汀参加提前投票后接受记者采访。
政府为什么会介入这些事情?在公共讨论中,「监管」这个词过于宽泛。它容易让人想到一个已经运转起来的市场,国家随后站到旁边设置限制。现实更接近米歇尔·福柯(Michel Foucault)讨论过的「安全」(security)。
福柯关心的是,现代政府怎样处理那些不能被简单停止的流通。粮食流通、人口移动以及经济活动都不能随意停止,但治理者需要计算流通中的「风险」,再通过价格、空间安排和基础设施改变事情发生的概率。到了《生命政治的诞生》,福柯进一步说明,自由主义并不意味着国家退出市场。市场自由本身需要被组织,也伴随着需要治理的安全成本。[4]
今天美国的AI政策正呈现这种形状。《美国AI行动计划》要求加快能源扩张、数据中心许可和半导体制造,同时继续限制先进计算能力流向被视为战略竞争者的方向。[5] 对一家AI公司来说,这意味着项目何时通电、某些芯片能否跨境流动,仍然取决于政府掌握的制度通道。
美国白宫于2025年7月发布《赢得竞赛:美国AI行动计划》(Winning the Race: America’s AI Action Plan),将 AI 基础设施扩张、能源、数据中心、半导体制造以及国家安全置于同一政策框架之中。
上一代互联网企业也需要处理与政府的关系,区别在于,搜索引擎、社交网络和电子商务最关键的资源长期是用户、广告和交易。平台可以拿补贴换用户,再靠网络效应扩大规模。但今天的前沿AI企业需要不断增加电力和算力,那些过去像后台事务一样的能源、土地和产业许可,开始直接影响模型能否继续扩张。前沿AI竞争因此越来越具有重资产产业的特征。
政府不只是一个客户
如果AI企业只是想让政府审批更顺畅,没有必要把最好的企业产品以一美元的价格铺进联邦机构。政府还提供了一样普通用户很难提供的东西:特殊的任务环境。
像我这样的普通用户让模型写一封邮件,失败了大不了换一种提示词。情报分析、国防、科研或医疗行政里的失败则要具体得多。模型可能不理解某一类文件关系,也可能因为安全策略过于保守而拒绝处理本来允许处理的材料,或者根本无法满足审计要求。政府机构不会只告诉供应商「这个功能不好用」,它会在一次次部署中暴露出普通消费市场很少遇到的能力边界。
OpenAI 在2025年6月推出 OpenAI for Government,把国家实验室、空军研究实验室、NASA、NIH、财政部和 ChatGPT Gov 放进同一条业务线,同时宣布与美国国防部首席数字与人工智能办公室合作,合同上限两亿美元,试验内容涉及军人医疗服务、项目与采购数据处理和网络防御。[6]
Anthropic 的做法更能说明这种政府业务和普通软件销售的区别。Claude Gov 这组模型根据政府客户的「直接反馈」开发,并针对机密材料、情报与国防文件、关键语言和网络安全数据进行了调整,Anthropic 列出的应用场景已经包括情报分析、威胁评估和行动支持。[7]
Anthropic 于2025年6月发布 Claude Gov,专门面向美国国家安全机构。该组模型根据政府客户的直接反馈开发,并针对机密材料、情报与国防文件、关键语言和网络安全任务进行调整。
这些新的反馈会重新进入产品开发。公司因此能够知道,一项功能究竟会在哪些地方被政府机构拒绝,什么能力可能成为下一轮采购的门槛,也会更早熟悉日志保存、权限控制和审计等实际要求。
过去许多政务软件主要负责把已经确定的行政流程数字化,例如申请人填写表格,工作人员按照既定规则审核,软件负责记录、传递和归档。大模型试图进入的则是那些还没有被完全写成固定步骤的工作。例如阅读大量材料、比较不同文件、提取线索、形成摘要,或者为工作人员提供初步判断。模型能否真正承担这些任务,单靠实验室里的测试很难知道,必须在具体工作环境中不断触碰真实问题。
于是,产品边界并没有在签合同时完全确定。政府客户因此不只是订单来源,它还提供了一处真实的产品发现现场:模型哪里会失败,哪些能力会成为采购门槛,安全和审计要求又会怎样改变产品。谁更早进入这种环境,谁就更早获得这些生产信息。「一美元」买到的,正是这种提前进入的机会。
没有名字的分类
问题也从这里开始变得政治化。
政府办公室里每天都在制造分类。福利资格、调查标准以及一名申请人是否符合某项条件,都由行政机关根据既有的分类判断。詹姆斯·斯科特(James C. Scott)在《国家的视角》中把现代国家长期积累的这种能力称为「可读性」。国家需要把生活里杂乱的事实变成可以登记和比较的行政对象,病历、税册和案件卷宗都是这种可读性的具体形式。[8]
AI进入政府,首先会接手已经存在的分类。如果过去某些社区被警察记录得更多,那么历史数据里的「犯罪」就已经包含了过去警力部署的结果。福利反欺诈也是如此。过去谁更容易被调查,会影响后来系统看到的「风险」。
机器学习又往前走了一步。它可以让分类不再完全由法律和办事规则事先规定。美国行政管理和预算局在2025年的联邦AI规则里,特意把仅按照「人工预设规则」运行的自动化程序排除在AI定义之外,而把机器学习和生成式AI纳入其中。[9]将这个技术区别放到行政实践里的重要性还没有得到公众的足够重视。传统规则系统出了问题,人们通常还能找到那条规则。机器学习的风险评分却可能从大量历史数据中寻找相关性,再把一个人推入某个概率区间。法律里从来没有「高风险福利领取者」这种正式身份,行政机关却可以根据一个分数决定优先审查谁。
鹿特丹的福利反欺诈系统提供了一个具体案例。2017年,鹿特丹开始用机器学习给福利领取者计算欺诈风险。系统使用315项输入,为每个人生成0到1之间的风险分数,分数靠前的人更可能被调查。[10]福利领取者看不到这315项变量,他真正感受到的是调查员找上了门。这让我想到「现代国家」形成时反复出现的那个场景:国王的税收官员敲开农民的门,带来的不是解释,而是一个已经计算好的数字。
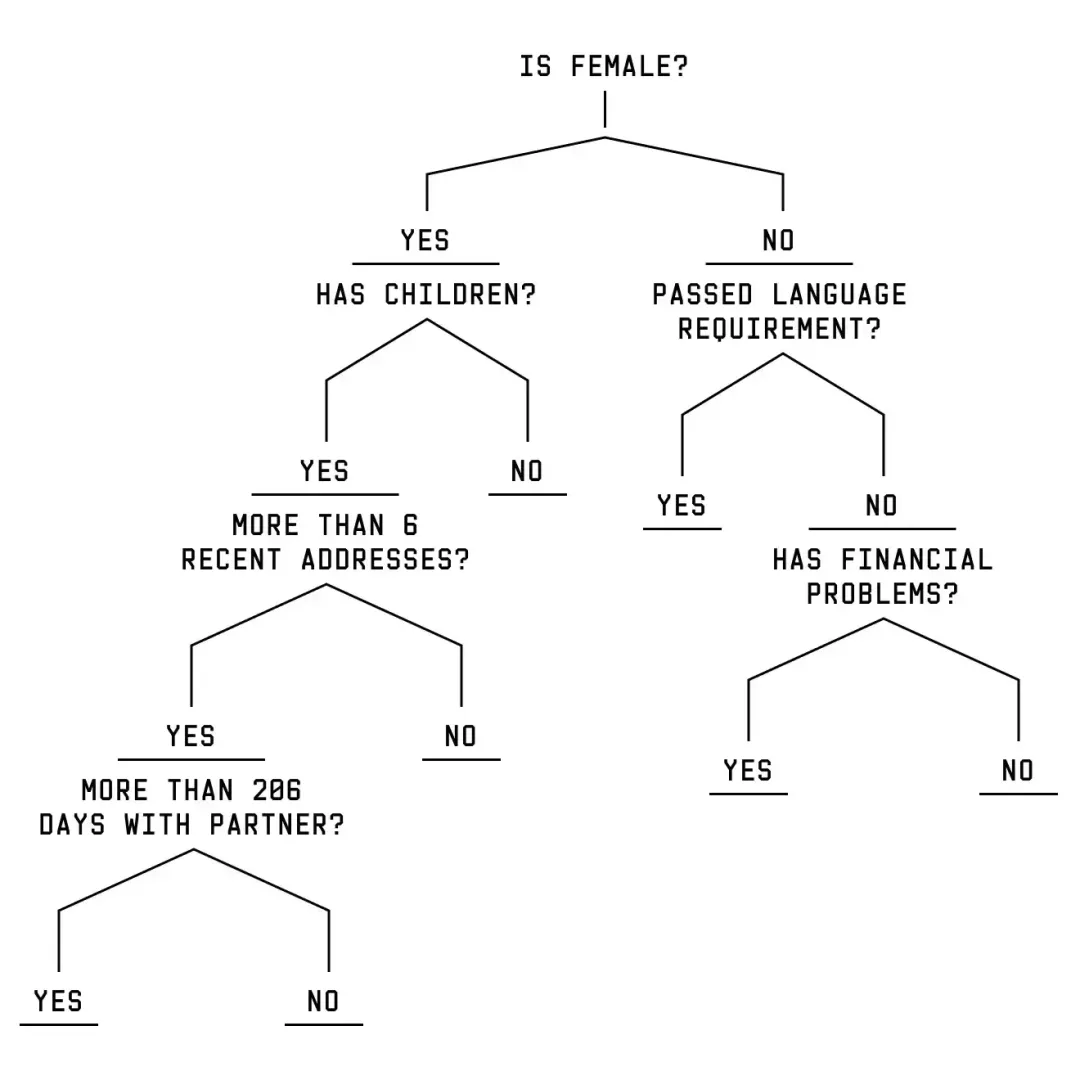
鹿特丹福利反欺诈算法的一棵简化决策树。性别、是否有子女、荷兰语能力、居住变动和经济状况等变量,会把福利领取者导向不同的风险判断路径。鹿特丹实际使用的模型由500棵决策树共同计算风险分数。图片:WIRED《Inside the Suspicion Machine》,2023。
在这类系统中,有些变量很难直接和「欺诈」建立联系。例如「不会说流利的荷兰语」,就会提高风险分数。对一个刚进入福利系统的人来说,语言困难本来可能意味着他需要更多公共服务,但在模型里,它却是一个值得怀疑的信号。「经济困难」本来正说明福利制度存在的理由,系统却可能把这种脆弱性折算成更高的调查概率。性别、是否有孩子以及工作人员对当事人的主观评价,都会影响结果。[11]
这里发生的事情并不只是媒体热衷讨论的「算法偏见」。行政机关过去就会怀疑某些人,社会中的性别、族群和移民不平等也不是算法发明的。模型做的是重新组织这些材料。语言能力、家庭情况和工作人员印象原本彼此分散,现在被压进同一个风险分数。这个分数又产生新的行政后果:谁被优先审查,谁需要额外证明自己的清白。
英国科学院院士路易丝·阿穆尔(Louise Amoore)把这类风险计算称为「数据衍生物」(data derivative)。她研究安全治理时发现,风险往往不是从某个明确属性中直接识别出来的,而是由许多零散信息之间的关联推导出来。密歇根大学的约翰·切尼-利波尔德(John Cheney-Lippold)讨论「算法身份」(algorithmic identity)时也指出,算法可以根据行为痕迹推断一个人所属的类别。[12]
政治地理学者路易丝·阿穆尔(Louise Amoore)在「Our Lives with Algorithms」讲座中讨论算法如何把复杂、含混的现实压缩成可用于判断和行动的分类结果。本文关于「数据衍生物」与算法风险分类的讨论与其研究直接相关。图片:Alexander von Humboldt Institute for Internet and Society(HIIG)。
这里还有一个更难处理的政治后果。过去许多治理分类虽然带有压迫性,却至少拥有公开名称。「移民」「失业者」「福利领取者」等身份,由法律、行政和社会关系固定下来,既可能成为治理的对象、运动反对的目标,也可能被人们重新占用,成为组织政治行动的基础。机器学习生成的风险分类却未必如此。一个人可能因为几十项变量的组合进入某个「高风险」区域,却不知道这个群体叫什么。当分类从法律和政策文本转移到了模型后台,就产生一个新的组织问题:如果共同处境首先表现为数据库中的概率关系,被治理者如何发现彼此?
生成式AI还可能把更多原本难以结构化的材料带进这种政治判断。案件叙述、访谈记录和长篇报告都可以直接交给大模型处理。现阶段不能因此断言 ChatGPT Enterprise 或 Claude 已经在美国联邦政府里决定福利和移民资格,但这类模型的确已经进入办公、科研和国家安全任务。美国政府也已经把执法风险评估、移民与庇护判断、公共福利资格和医疗资源分配列为「高影响AI」的典型用途。[13]
在一切变得难以退出之前
到这里,问题已经不只是AI如何参与政府分类,而是这些技术安排在进入基础设施和行政流程时,公众还能在什么地方介入。
基础设施这一侧,最直接的问题不是「要不要发展AI」,而是谁承担建设成本。
北弗吉尼亚拥有全球最密集的数据中心集群之一。新的AI负荷让电网扩张成本成为州政治问题。皮埃蒙特环境委员会(Piedmont Environmental Council, PEC)从2021年开始联合地方组织介入数据中心的选址、土地和电力争议。2025年,它又发起「Virginians for a Smarter Digital Future」,把原本抽象的产业政策拉回居民能够判断的生活问题:新的输电设施为什么建在这里?电价上涨由谁承担?地方政府为了吸引大型项目承诺了什么?[14]如果一家大型企业要求公用事业公司提前为它建设专用能力,后来项目缩水,沉没成本是不是应该由所有居民共同承担?
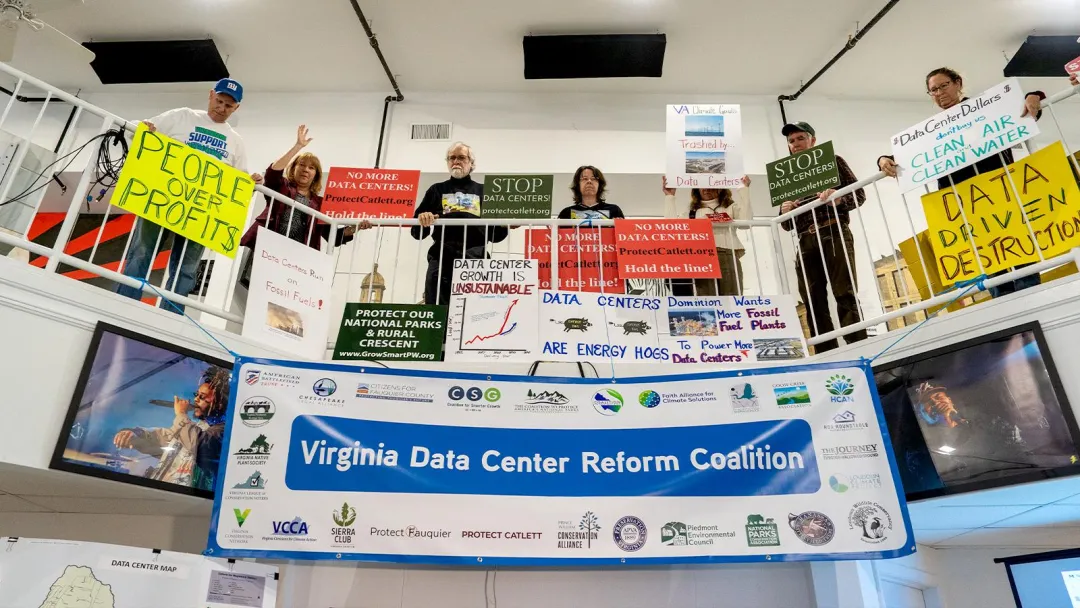
弗吉尼亚数据中心改革联盟成员与地方居民参加数据中心改革行动。该联盟由环保、社区、历史保护等组织组成,长期围绕电网成本、土地利用、水资源和数据中心扩张推动州级改革。图片:Hugh Kenny / Piedmont Environmental Council。
弗吉尼亚州公司委员会后来设立新的 GS-5 大型用电客户类别,就是在处理这个问题。部分大型数据中心需要承担更长期的用电承诺,即使实际用电低于预期,也要支付相当比例的输配电费用。监管机构给出的理由是:不能让普通用户替大型负荷客户承担过多的电网扩张风险。[15]
公共支持也可以有另一种去向。美国国家科学基金会主持的国家人工智能研究资源(National Artificial Intelligence Research Resource, NAIRR)把政府和企业提供的计算资源、模型、数据和软件开放给研究人员、教育者和学生。到2026年,该项目已经支持600多个研究项目和约6000名学生。[16] 虽然NAIRR 的规模仍然有限,但它至少证明,公共投入形成的计算能力并不只能留在大型企业内部。
在产品这一侧,首要问题则是让隐藏的分类变得可见。
2020年,英国移民福利联合委员会(Joint Council for the Welfare of Immigrants, JCWI)在技术公益组织 Foxglove 支持下,对英国内政部的签证「分流工具」提起司法审查。批评者认为,国籍等因素可能使某些申请更容易进入高风险通道。案件还没有正式开庭,内政部就宣布停止使用原来的工具,并重新检查整个流程。[17]这场诉讼把一套藏在行政后台的分类机制推入了公共争论。公众终于能够问出那个问题:为什么某些人的申请更容易被系统认为值得怀疑?
同时,欧盟《人工智能法》要求公共机构等主体在部署部分高风险AI系统以前进行基本权利影响评估。荷兰建立了中央算法登记册,到2026年8月已经公开1500个公共部门算法项目。美国行政管理和预算局对「高影响AI」也要求部署前测试、影响评估和持续监测,并在一些场景下提供人工复核和申诉渠道。[18]这些手续不会自动产生公平,但没有最基本的信息公开,被影响的人甚至不知道行政机关正在用什么系统处理自己的申请、资格或案件。
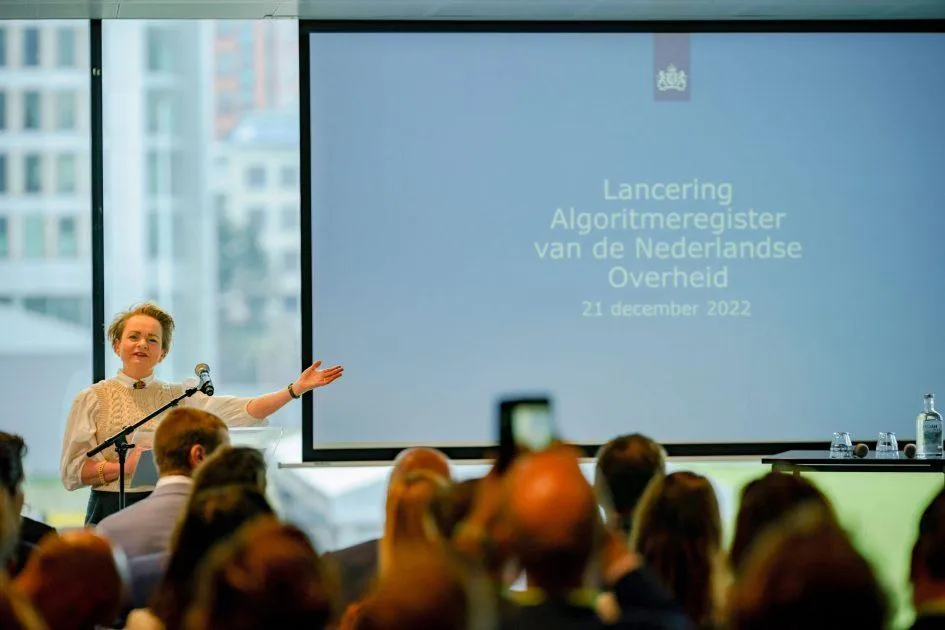
2022年12月21日,荷兰政府正式推出中央算法登记册。公共机构可在其中公开其使用的算法、用途和相关说明,使公民、媒体和社会组织能够查询并监督政府的算法使用。图为算法登记册发布现场。
大模型采购还多出一个「退出成本」的问题。「一美元」让模型进入政府时,切换供应商的成本几乎不可见。但等培训、知识库和工作流都依赖同一供应商以后,退出价格就会真正显现出来。这里和基础设施建设遇到的是同一种时间问题:越晚介入,重新谈判的空间就越小。因为电网一旦建成,成本分担方式就很难重新调整,而风险评分一旦被嵌进行政流程,公众面对的就是既成的分类结果。政府采购大模型也是如此,审计、迁移和退出条件应当在最初签约时就进入公共讨论,而不是等依赖已经形成以后再补救。
当模型竞赛和AI焦虑都在不断把未来提前,真正应该被提前的不是恐慌,而是政治。67.2%的黎曼猜想?一个AI恐慌的生产现场
布莱希特式的阅读
1935年,贝托尔特·布莱希特(Bertolt Brecht)在《一个工人读书时的疑问》里,让一个工人翻开历史书。书上写着国王修建城市,凯撒赢得战争。工人却在寻找那些被句子的主语省略的人:搬运石头的人,胜利之后准备宴席的人。[19]
年轻的亚历山大征服印度。
他一个人吗?
今天关于AI的新闻也喜欢使用清楚的主语:OpenAI 建造了数据中心,Anthropic 拿到了政府合同,某个模型又获得一种新能力。布莱希特式的阅读不会直接否认这些事实,但他大概会把目光移向句子的外部:为数据中心扩建的变电站、居民收到的电费账单。进入政府办公室以后,他还会注意到把福利领取者变成风险分数的表格。
「一美元」写在合同首页,但变电站的成本、后台生成的风险分数,以及多年以后政府想换掉这套系统时要付出的代价,都没有写进合同。
每一页一个胜利。
谁烹调胜利的欢宴?
每十年一个伟人,
谁付出那些代价?
▼ 注释(框内可滑动)
[1] 美国联邦总务署(GSA)于2025年8月6日宣布与 OpenAI 达成 OneGov 安排,参与的联邦行政机构可在一年内以每机构1美元使用 ChatGPT Enterprise;8月12日,GSA 与 Anthropic 宣布 Claude for Enterprise 和 Claude for Government 面向行政、立法、司法三个分支,价格同为每机构1美元;8月21日,GSA 宣布 Gemini for Government 的价格为每机构0.47美元。参见 GSA, 「GSA Announces New Partnership with OpenAI, Delivering Deep Discount to ChatGPT Gov-Wide Through MAS」, 6 August 2025;GSA, 「GSA Strikes Another OneGov Deal with Anthropic to Offer Claude AI to all Branches of Gov for Just $1」, 12 August 2025;GSA, 「GSA, Google Announce Transformative ‘Gemini for Government’ OneGov Agreement」, 21 August 2025。
[2] 美国商务部工业与安全局(BIS)对部分先进计算芯片及相关物项设置出口许可、最终用户和最终用途控制,并将其与军事、情报和大规模杀伤性武器用途联系。参见 Bureau of Industry and Security, 「BIS Policy Statement on Controls that May Apply to Advanced Computing Integrated Circuits and Other Commodities Used to Train AI Models」, 13 May 2025;BIS, 「Commerce Further Restricts China’s Artificial Intelligence and Advanced Computing Capabilities」, 25 March 2025。
[3] 2026年8月3日,德州州长阿博特要求 Texas Public Utility Commission 与 ERCOT 对正在大型负荷并网流程中推进的数据中心进行全面核验,审核完成前项目不得继续推进。州长办公室称 ERCOT 当时正在考虑超过474吉瓦的潜在大型负荷接入请求。该措施针对并网项目审核,并不等于德州全面禁止新建数据中心。参见 Office of the Texas Governor, 「Governor Abbott Directs Comprehensive Data Center Audit」, 3 August 2026。
[4] 米歇尔·福柯关于「安全」和「环境」的讨论主要见 Michel Foucault, Sécurité, territoire, population. Cours au Collège de France, 1977–1978, Paris: Gallimard/Seuil, 2004;英译本 Security, Territory, Population: Lectures at the Collège de France, 1977–78, trans. Graham Burchell, New York: Palgrave Macmillan, 2007。关于自由主义如何同时生产自由并承担其安全成本,见 Michel Foucault, Naissance de la biopolitique. Cours au Collège de France, 1978–1979, Paris: Gallimard/Seuil, 2004;英译本 The Birth of Biopolitics, trans. Graham Burchell, New York: Palgrave Macmillan, 2008。本文借用的是福柯对安全机制如何处理流通的分析。
[5] 白宫《美国AI行动计划》把建设AI基础设施列为核心支柱,提出加快数据中心、半导体制造和能源基础设施许可,并要求关键AI基础设施避免使用被视为敌对国家控制的相关技术。参见 The White House, America’s AI Action Plan, July 2025。
[6]OpenAI 于2025年6月16日推出 OpenAI for Government,把国家实验室、空军研究实验室、NASA、NIH、财政部和 ChatGPT Gov 等既有合作纳入统一业务框架,并宣布与美国国防部首席数字与人工智能办公室合作的试点项目,合同上限为2亿美元。参见 OpenAI, 「Introducing OpenAI for Government」, 16 June 2025。
[7]Anthropic 于2025年6月发布 Claude Gov,明确称该组模型「基于政府客户的直接反馈」开发,并增强了机密材料处理、情报与国防文件理解、关键语言和网络安全数据分析能力。参见 Anthropic, 「Claude Gov models for U.S. national security customers」, 6 June 2025。
[8]James C. Scott, Seeing Like a State: How Certain Schemes to Improve the Human Condition Have Failed, New Haven: Yale University Press, 1998。斯科特讨论固定姓名、地籍、标准度量衡和人口统计等制度怎样把地方性社会实践转化为国家能够识别和处理的简化形式。本文把这一问题延伸到公共机构使用AI后的行政分类。
[9]OMB M-25-21 对AI的解释包括机器学习、强化学习、迁移学习和生成式AI,同时排除行为仅由人工定义规则决定的机器人流程自动化等系统。参见 Office of Management and Budget, M-25-21: Accelerating Federal Use of AI through Innovation, Governance, and Public Trust, 3 April 2025。
[10] 鹿特丹自2017年起使用机器学习模型为福利领取者计算欺诈风险。Lighthouse Reports 与《连线》获得模型和技术资料后发现,系统使用315项输入,生成0至1之间的风险分数,并据此排序调查对象。参见 Lighthouse Reports, 「Suspicion Machines」, 6 March 2023。
[11] 《连线》与 Lighthouse Reports 的重建显示,年龄、性别、荷兰语能力、家庭情况以及工作人员的主观评价都会影响风险分数;调查者认为系统对女性、移民和其他脆弱群体产生明显不利影响。参见 Eva Constantaras et al., 「Inside the Suspicion Machine」, WIRED, 6 March 2023。
[12]Louise Amoore, 「Data Derivatives: On the Emergence of a Security Risk Calculus for Our Times」, Theory, Culture & Society 28, no. 6 (2011): 24–43;John Cheney-Lippold, 「A New Algorithmic Identity: Soft Biopolitics and the Modulation of Control」, Theory, Culture & Society 28, no. 6 (2011): 164–181。
[13]OMB M-25-21 将对个人权利、安全或关键资源产生重大影响的部分AI用途列为「高影响AI」,包括执法风险评估、移民与庇护判断、公共住房和福利资格、医疗诊断与资源分配等。相关用途需要遵守部署前测试、AI影响评估、持续监测等风险管理要求。参见 M-25-21。
[14]Piedmont Environmental Council 表示,其自2021年以来组织全州联盟推动弗吉尼亚州数据中心治理改革,并于2025年推出「Virginians for a Smarter Digital Future」,将电价、土地、环境影响和公共决策透明度作为主要议题。参见 Piedmont Environmental Council, 「2025 Impact Report」。
[15] 弗吉尼亚州公司委员会于2025年批准新的 GS-5 大型用电客户类别,适用于包括数据中心在内的超大负荷用户。部分客户需要承担至少14年的合同义务,并支付至少85%的输电和配电成本,以减少成本向普通用户转移。参见 Virginia State Corporation Commission, 「SCC Issues Order on DEV Biennial Review 2025」, 25 November 2025;Virginia SCC, 「SCC Data Center Initiatives」, February 2026。
[16] 美国国家科学基金会主持的 National Artificial Intelligence Research Resource(NAIRR)于2024年以试点形式启动,通过政府和私人伙伴提供计算、数据、模型、软件与教育资源。到2026年,NSF 称其已支持600多个研究项目和约6000名学生。参见 National Science Foundation, 「National Artificial Intelligence Research Resource」;「NAIRR at 2 years: Advancing American artificial intelligence innovation and leadership」, 19 March 2026。
[17] 2020年,Joint Council for the Welfare of Immigrants 在 Foxglove 支持下就英国内政部签证「streaming tool」提起司法审查,质疑系统存在歧视性分流。案件正式开庭前,内政部宣布停止使用原有工具并重新审查流程。参见 Foxglove, 「Update: papers filed for judicial review of the Home Office’s visa algorithm」, 22 June 2020;Foxglove, 「Home Office says it will abandon its racist visa algorithm – after we sued them」, 4 August 2020。
[18] 欧盟《人工智能法》第27条要求部分公共机构和公共服务主体在部署特定高风险AI之前进行基本权利影响评估。荷兰建立了中央算法登记册,到2026年8月已经登记约1500项公共部门算法。美国 OMB M-25-21 对高影响AI要求部署前测试、影响评估、持续监测和适当的人工监督。
[19] 贝托尔特·布莱希特,《一个工人读书时的疑问》(Fragen eines lesenden Arbeiters),1935年,后收入《斯文堡诗集》(Svendborger Gedichte)。